무엇이 다른가
찾는 AI와 읽는 AI를 함께 씁니다
객체 감지는 빠르게 찾고, VLM은 그 장면을 읽어 왜 위험한지 설명합니다.
| 구분 | 객체 감지 | VLM 상황 판단 |
|---|---|---|
| 하는 일 | 불꽃, 연기, 작업자, 차량을 찾아냅니다. | 감지한 장면을 읽고 상황을 판단합니다. |
| 결과 | 무엇이 어디에 있는지 알려 줍니다. | 위험 수준과 원인을 문장으로 제시합니다. |
| 역할 | 실시간으로 위험 신호를 포착합니다. | 한 번 더 확인해 오탐을 줄입니다. |
안전네컷 안에서 두 모델이 맡는 역할을 비교한 것입니다.
실제 판독 예
불꽃을 이렇게 읽었습니다
현장에서 기록된 이벤트 한 건입니다. 현장 영상은 흐리게 가렸습니다.
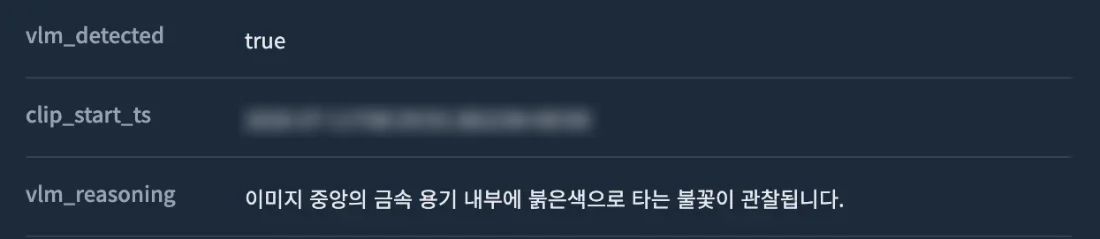
VLM 판독 문장
이미지 중앙의 금속 용기 내부에 붉은색으로 타는 불꽃이 관찰됩니다.
- 이벤트 유형
- 화재
- 심각도
- 높음
- 확인 상태
- 담당자 확인 완료
판단 흐름
감지한 장면을 한 번 더 읽습니다
01감지불꽃, 연기, 작업자, 차량을 실시간으로 찾아냅니다.
02보류VLM이 확인하기 전까지 알림을 보류합니다.
03판독VLM이 장면을 읽고 위험 수준과 원인을 문장으로 제시합니다.
04알림확인된 이벤트를 알리고 판독 문장을 함께 기록합니다.
05개선현장 사례로 판단을 개선합니다.
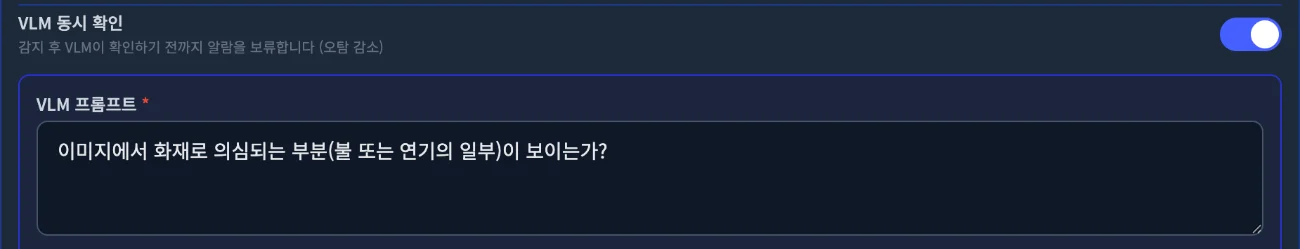
질문 설정
무엇을 확인할지 질문으로 정합니다
- 규칙마다 켜고 끕니다VLM 동시 확인은 규칙마다 켜고 끌 수 있습니다.
- 질문을 직접 적습니다확인할 내용을 문장으로 적어 둡니다. 예: “이미지에서 화재로 의심되는 부분이 보이는가?”
- 기준을 정합니다최소 신뢰도와 설명을 만드는 기준을 규칙에서 정합니다.
바디캠 판독
작업 장면도 항목별로 읽습니다
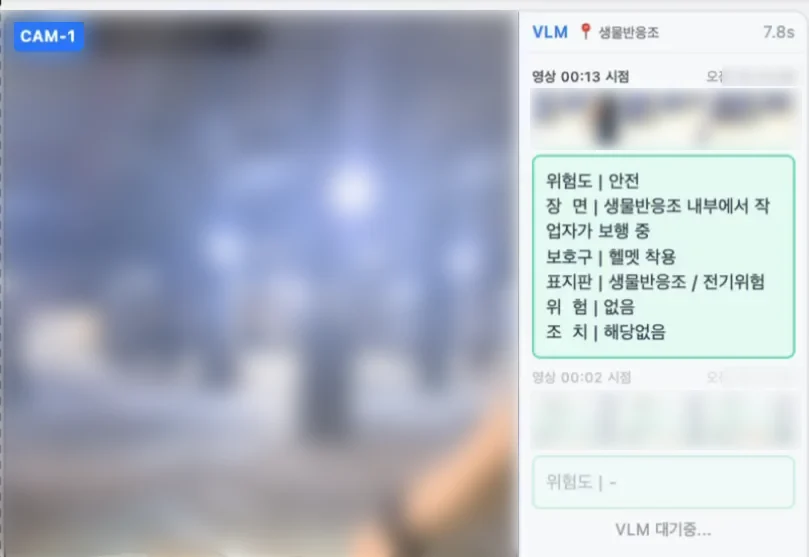
- 위험도장면의 위험도를 먼저 제시합니다.
- 장면과 보호구작업자가 무엇을 하는지, 보호구를 착용했는지 적습니다.
- 표지판주변의 표지판을 읽습니다.
- 위험과 조치위험 요소와 필요한 조치를 정리합니다.
차별점
현장에 맞게 판단합니다
현장 맥락을 이해하는 AI
물체를 찾는 데서 그치지 않고 ‘왜 위험한지’까지 문장으로 설명합니다.
현장 경험을 반영하는 판단
여러 단계의 판정과 필터로 오탐을 줄이고 현장 사례로 판단을 개선합니다.
폐쇄망 운영
인터넷 없는 폐쇄망에서 현장의 엣지 장비로 실시간 분석합니다.
연구개발
상황인식 기술을 과제로 고도화하고 있습니다
모멘트큐브가 주관기관으로 수행하는 정부 과제입니다.
FAQ
VLM 상황 판단 자주 묻는 질문
VLM이 무엇인가요?
영상과 언어를 함께 이해하는 AI 모델입니다. 안전네컷에서는 감지한 장면을 읽고 위험 수준과 원인을 문장으로 제시하는 데 씁니다.
오탐은 어떻게 줄이나요?
여러 단계의 판정과 필터로 조명이나 반사 같은 오탐 요인을 거르고, VLM이 상황을 한 번 더 확인합니다.
인터넷이 없는 현장에서도 쓸 수 있나요?
네. 안전네컷은 인터넷 없는 폐쇄망에서 현장의 엣지 장비로 실시간 분석합니다.
VLM이 확인할 내용을 바꿀 수 있나요?
네. 규칙마다 VLM 동시 확인을 켜고, 확인할 내용을 질문으로 적어 둘 수 있습니다.